KI-Sichtbarkeit messen: So bewertest du deinen GEO-Erfolg
Geschätzte Lesezeit: 11 Min.

Deine Marke erscheint in einer KI-Antwort. Ist das schon ein Erfolg? Erst wenn du weißt, bei welchen Fragen sie auftaucht, wie sie dargestellt wird und was daraus entsteht, kannst du den Nutzen beurteilen. Wenn du KI-Sichtbarkeit messen möchtest, brauchst du deshalb ein nachvollziehbares Messkonzept.
Dieser Leitfaden zeigt dir, wie du mit eigenen Testfragen startest, ChatGPT, Claude, Gemini sowie Google AI Overviews und AI Mode getrennt auswertest und aus deinen Beobachtungen konkrete Aufgaben ableitest.
Das Wichtigste in Kürze
KI-Sichtbarkeit misst du durch wiederholte Tests relevanter Kundenfragen, dokumentierte Markenerwähnungen und Quellenlinks. Ergänze Googles eigene Sichtbarkeitsdaten sowie erkennbare Websitebesuche und Geschäftsergebnisse. Vergleiche stets dieselben Fragen unter möglichst gleichen Bedingungen. Eine Erwähnungsquote beschreibt deine Stichprobe; sie ist weder Marktanteil noch Umsatznachweis.
Was bedeutet KI-Sichtbarkeit messen?
KI-Sichtbarkeit beschreibt, ob und wie deine Marke, Produkte oder Inhalte in generierten Antworten erscheinen. GEO-Monitoring ist die wiederkehrende Beobachtung dieser Präsenz. GEO steht für Generative Engine Optimization; die Grundlagen erklärt unser Beitrag zu Chancen und Grenzen von GEO.
Für deine Auswertung solltest du drei Ebenen auseinanderhalten:
- Präsenz: Wird deine Marke genannt oder eine eigene Seite verlinkt?
- Darstellung: Wird dein Angebot passend beschrieben, empfohlen oder falsch eingeordnet?
- Geschäftsergebnis: Entstehen erkennbare Besuche, qualifizierte Anfragen oder Käufe?
Eine KI kann einen Fachartikel deiner Website verlinken, ohne deinen Unternehmensnamen zu nennen. Sie kann deine Marke empfehlen und dabei auf eine fremde Website verweisen. Beides gehört in dein Protokoll, aber in unterschiedliche Felder.
Lege zuerst fest, welche Entscheidung das Reporting unterstützen soll. Ein Marketing-Team könnte herausfinden wollen, bei welchen Anbieterfragen Wettbewerber genannt werden und welche Informationen auf den eigenen Leistungsseiten fehlen.

Wie wählst du die richtigen Fragen für dein Monitoring?
Ein Prompt-Set ist eine festgelegte Sammlung von Eingaben, die du wiederholt untersuchst. Es sollte Situationen deiner Zielgruppe abbilden: Orientierung, Problemlösung, Vergleich und Anbieterauswahl.
Nutze dafür Kundenanfragen, Vertriebsgespräche, interne Shopsuchen und Search-Console-Daten. Eine systematische Keyword-Recherche hilft dir, Themen zu erkennen. Google-Suchvolumen ist dabei kein Beleg dafür, wie häufig eine Frage in einem Chatbot gestellt wird.
Für einen ersten manuellen Durchlauf kannst du beispielsweise zehn sorgfältig ausgewählte Fragen verwenden. Das ist eine praktikable Startgröße, kein allgemeiner Qualitätsstandard. Untersuche zunächst einen klaren Themenbereich.
Geeignete Fragen könnten lauten:
- „Welche Kriterien sind bei einer CRM-Einführung in einem kleinen Vertriebsteam wichtig?“
- „Welche Dienstleister begleiten CRM-Einführungen für mittelständische Unternehmen in Deutschland?“
- „Welche Fahrradpacktaschen eignen sich für tägliches Pendeln bei Regen?“
- „Welche Onlineshops bieten Ersatzteile für Fahrradpacktaschen an?“
Trenne Fragen ohne Markennamen von direkten Markenabfragen. „Was bietet Unternehmen X an?“ prüft die Darstellung einer bereits bekannten Marke. Es beantwortet nicht, ob das Unternehmen bei einer offenen Anbietersuche auftaucht.
Lass deine eigene URL in solchen offenen Tests weg. Sonst lenkst du die Antwort auf eine Quelle, die du eigentlich unabhängig beobachten möchtest. Zusätzliche Formulierungsvarianten kannst du separat testen; das feste Vergleichsset bleibt bestehen.
Wie unterscheiden sich die untersuchten KI-Systeme?
Behandle ChatGPT, Claude, Gemini, AI Overviews und AI Mode als fünf getrennte Messbereiche. Auch Gemini und Googles Suchfunktionen sollten eigene Auswertungen erhalten.
ChatGPT: Suchmodus und Quellen festhalten
Dokumentiere bei ChatGPT, welches Modell beziehungsweise welcher Modus verwendet wurde und ob eine Websuche stattgefunden hat. Nach den Hinweisen zur ChatGPT-Suche können Suchantworten Quellenverweise enthalten.
Eine Antwort ohne sichtbare Quellen liefert dir keine vollständige Liste der verwendeten Informationen. Erfasse daher nur beobachtbare Nennungen und Verlinkungen. Frage nicht nachträglich „Warum empfiehlst du uns?“ und behandle die Erklärung als Beweis für einen Rankingfaktor.
Claude: Websuche gesondert dokumentieren
Claude beschreibt in seiner Dokumentation zur Websuche, wie Antworten mit aktuellen Webquellen ergänzt werden. Halte fest, ob die Suche tatsächlich genutzt wurde.
Trenne normale Suchantworten von umfangreichen Rechercheläufen. Wenn du im ersten Monat einen kurzen Chat testest und im zweiten Monat eine ausführliche Recherche, vergleichst du unterschiedliche Situationen.
Gemini: sichtbare Links sorgfältig einordnen
Google erklärt in den Hinweisen zu Quellen in Gemini, dass nicht jede Antwort Quellen enthält. Angezeigte Links können zu Quellen oder zugehörigen Inhalten führen.
Protokolliere deshalb die konkrete URL und ihre Rolle. Ein weiterführender Link ist nicht automatisch ein belegter Ursprung jeder Aussage. Verwende für das Monitoring öffentlicher Sichtbarkeit keine hochgeladenen Unternehmensunterlagen oder verbundenen internen Dokumente.
Google: AI Overviews und AI Mode getrennt beobachten
Bei AI Overviews prüfst du zunächst, ob für die Suchanfrage überhaupt eine KI-Übersicht erscheint. Danach erfasst du Marke, Links und Kontext. AI Mode erhält einen eigenen Durchlauf; Folgefragen behandelst du als separate Tests.
Ergänzend dokumentiert Google einen Bericht zur Leistung in generativen KI-Funktionen. Er zeigt Impressionen für AI Overviews und AI Mode und erlaubt Auswertungen nach Seiten, Ländern, Geräten und Datum.
Damit ergänzt du deine Tests um tatsächliche Ausspielungsdaten für die eigene Website. Der Bericht misst jedoch keine ChatGPT-, Claude- oder Gemini-Nennungen. Fehlt er, kann laut Google eine zu geringe Zahl entsprechender Impressionen die Ursache sein.

Wie führst du einen manuellen Sichtbarkeitstest durch?
Für den Einstieg genügt eine strukturierte Tabelle. Jede Zeile steht für eine Frage in einem System zu einem Zeitpunkt.
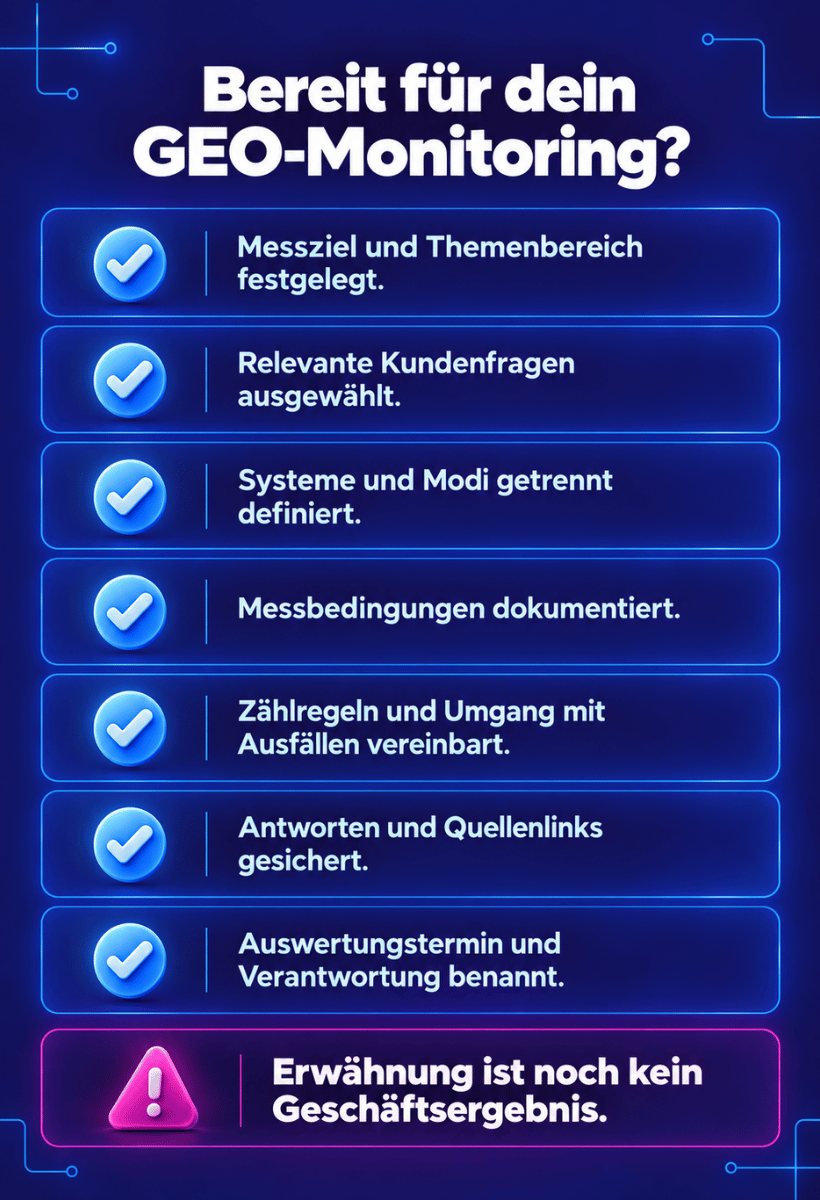
- Messbereich festlegen: Thema, Zielgruppe, Sprache, Markt und Vergleichsunternehmen auswählen.
- Fragen nummerieren: Wortlaut, Thema und Entscheidungssituation hinterlegen.
- Bedingungen dokumentieren: Datum, System, Modell, Modus, Websuche, Standort und Kontokontext erfassen, soweit erkennbar.
- Tests durchführen: Je Frage einen neuen Chat beziehungsweise Suchlauf beginnen. Keine vorherigen Antworten als Kontext mitgeben.
- Ergebnis sichern: Vollständige Antwort oder Screenshot sowie sichtbare Quellenlinks speichern.
- Antwort bewerten: Marke genannt, eigene URL verlinkt, Empfehlung vorhanden, Angaben korrekt und Wettbewerber genannt?
- Messung wiederholen: Das gleiche Set an weiteren festgelegten Terminen untersuchen.
Reduziere persönliche Einflüsse, soweit die Oberfläche es zulässt. Ein neuer Chat entfernt nicht automatisch sämtliche Personalisierung. Dokumentiere verbleibende Unterschiede, statt vollständige Neutralität zu behaupten.
Unterscheide außerdem kein Treffer von technischem Ausfall. Eine gültige Antwort ohne deine Marke ist ein negatives Beobachtungsergebnis. Eine fehlgeschlagene Abfrage wird als Ausfall erfasst und nicht stillschweigend zur Nichtnennung umgedeutet. Berichte neben den Quoten die Zahl gültiger und versuchter Tests.
Ein konkreter Einstieg: Zehn Fragen an drei Messzeitpunkten ergeben pro Chatbot 30 Antworten. Für ChatGPT, Claude und Gemini sind das zusammen 90. Die beiden Google-Messbereiche führst du zusätzlich und separat.
Welche GEO-Kennzahlen brauchst du wirklich?
Beginne mit wenigen Kennzahlen, deren Berechnung dein Team versteht. Definiere für jede Quote den Nenner und die Zählregel.
Erwähnungsquote und Quellenlinkquote
Die Erwähnungsquote berechnest du als Antworten mit deiner Marke geteilt durch alle gültigen Antworten desselben Messbereichs, multipliziert mit 100. Mehrere Nennungen innerhalb einer Antwort zählen dabei als ein Treffer.
Die Quellenlinkquote berechnest du entsprechend mit Antworten, die mindestens eine eigene URL verlinken. Ein Link auf einen fremden Artikel über deine Marke zählt nicht als eigener Quellenlink.
Fiktives Rechenbeispiel: Deine Marke erscheint in 9 von 30 gültigen Antworten. Die Erwähnungsquote beträgt 30 Prozent. Eine eigene Seite wird in 6 Antworten verlinkt; die Quellenlinkquote beträgt 20 Prozent. Die Gruppen können sich überschneiden. Du darfst sie nicht zu 50 Prozent Sichtbarkeit addieren.
Bei AI Overviews ist die Grundgesamtheit besonders wichtig: Eine Sichtbarkeitsquote über alle geprüften Suchanfragen zählt eine ausgebliebene KI-Übersicht als fehlende Präsenz. Eine Quote nur innerhalb tatsächlich erschienener Übersichten beantwortet eine andere Frage. Berichte beide Größen eindeutig bezeichnet, wenn du sie verwendest.

Empfehlungsquote und Darstellungsqualität
Für eine Empfehlungsquote legst du vorher fest, was als Empfehlung zählt: beispielsweise eine ausdrücklich als passend eingeordnete Anbieteroption. Eine beiläufige Erwähnung genügt dafür nicht.
Bewerte zusätzlich, ob Leistungen, Produkte und Einschränkungen richtig dargestellt werden. Positive Tonalität allein reicht nicht. Eine freundlich formulierte Empfehlung für eine Leistung, die du gar nicht anbietest, ist ein Problem.
Wettbewerbsvergleich
Prüfe dieselben Fragen auch auf die ausgewählten Wettbewerber. Vergleiche zunächst deren Erwähnungsquoten pro System und Themenbereich.
Ein AI Share of Voice kann ergänzen, wie groß dein Anteil an den gezählten Markentreffern im festgelegten Vergleichsfeld ist. Dokumentiere dafür den Wettbewerberkreis und die Berechnung. Das ist kein Marktanteil und keine Reichweitenmessung aller KI-Nutzer.
Wie erkennst du Websitebesuche und Geschäftsergebnisse?
In GA4 hilft dir der Bericht „Neu generierte Zugriffe“. Verwende die Dimension „Sitzung – Quelle/Medium“, um erkennbare Zugriffe aus KI-Diensten zu untersuchen.
Prüfe zuerst, welche Quellen tatsächlich in deiner Property auftauchen. Suche beispielsweise nach passenden Einträgen für ChatGPT, Claude und Gemini. Erstelle daraus einen nachvollziehbaren Filter, statt jede Quelle mit dem Wort „AI“ einzuschließen.
Betrachte dann die besuchten Einstiegsseiten, Sitzungen, Schlüsselereignisse und gegebenenfalls Käufe. Im B2B-Bereich ergänzt du die Prüfung, ob eine Anfrage fachlich passt und ein realistisches Projekt enthält.
Diese Zuordnung bleibt unvollständig: Nicht jeder Besuch übermittelt eine eindeutig erkennbare Herkunft. Ein späterer direkter Besuch lässt sich nicht einfach einer früheren KI-Empfehlung zurechnen. Auch „google / organic“ ist kein eindeutiger Nachweis für einen Klick aus AI Overviews oder AI Mode.
Eine freiwillige Frage im Anfrageprozess wie „Wie bist du auf uns aufmerksam geworden?“ kann zusätzliche Hinweise liefern. Halte diese Selbstauskunft getrennt von technisch zugeordneten Besuchen fest.
Wann helfen SISTRIX und andere Monitoring-Tools?
Ein Tool wird hilfreich, wenn wiederkehrende Tests, Quellenkontrolle und Wettbewerbsvergleiche manuell zu aufwendig werden. Es automatisiert Beobachtungen; die Auswahl sinnvoller Fragen bleibt deine Aufgabe.
Mit dem Prompt-Monitoring von SISTRIX kannst du eigene Fragen festlegen und Entwicklungen, Wettbewerber sowie Quellen untersuchen. Die Produktseite nennt zum Recherchestand Oktober 2026 ChatGPT, AI Overviews, AI Mode und Perplexity.
Claude und Gemini sind dort nicht als abgedeckte Plattformen aufgeführt. Für dein vollständiges Messkonzept ergänzt du deshalb manuelle Tests oder prüfst ein weiteres Werkzeug auf die benötigte Abdeckung.
Peec AI und OtterlyAI sind weitere Anbieter für KI-Sichtbarkeitsmonitoring. Entscheidend sind die konkret gebuchten Systeme, die Datenerhebung und der Zugriff auf vollständige Antworten.
Prüfe vor einer Auswahl: Wird die öffentliche Chatoberfläche oder eine API getestet? Werden tatsächliche Websuchen erfasst? Kannst du Rohantworten, Quellen, Ausfälle und Änderungen im Prompt-Set nachvollziehen? Eine API-Antwort ist nicht automatisch mit der Antwort in einer Endnutzeroberfläche gleichzusetzen.
Vergleiche außerdem keine Sichtbarkeits-Scores verschiedener Anbieter, ohne deren Definition zu kennen. Gleiche Bezeichnungen können unterschiedliche Berechnungen meinen.
Wie wird aus einem Messwert eine sinnvolle Entscheidung?
Ein Monatsreport sollte beantworten: Was hat sich verändert, wodurch könnte es erklärt werden und welche Aufgabe folgt daraus?
Zeige absolute Trefferzahlen neben Prozentwerten. Bei 30 Antworten verändert ein einziger zusätzlicher Treffer die Quote bereits um rund 3,3 Prozentpunkte. Kleine Schwankungen solltest du deshalb nicht als sicheren Erfolg verkaufen.
Ordne Veränderungen nach System, Thema und Entscheidungssituation. Bleibt dein festes Fragen-Set bestehen? Wurde ein Modell gewechselt? Hat sich die Erhebung geändert? Solche Ereignisse gehören neben die Verlaufskurve.
Wiederkehrende Muster liefern Ansatzpunkte. Falsche Leistungsangaben sprechen für eine Prüfung eigener und fremder Unternehmensinformationen. Häufig zitierte Wettbewerberseiten können auf fehlende Entscheidungskriterien hinweisen. Besuche ohne passende Anfragen legen eine Prüfung von Landingpage, Angebot und Zielgruppenpassung nahe.
Ein zeitlicher Zusammenhang beweist keine Ursache. Selbst wenn nach einer Inhaltsänderung mehr Nennungen auftreten, können Modelländerungen, neue Drittquellen oder Wettbewerberaktivitäten mitwirken.
Wie sieht das in zwei Praxisbeispielen aus?
Die folgenden Fälle und Zahlen sind fiktive Beispiele, keine trepcademy-Kundenergebnisse.
Beispiel: B2B-Dienstleister für CRM-Einführungen
Ein Dienstleister untersucht zehn Fragen zur CRM-Einführung an drei Terminen in ChatGPT. In 9 von 30 Antworten wird er genannt, in 6 wird eine eigene Seite verlinkt.
Bei der qualitativen Prüfung zeigt sich: Mehrfach wird ihm eine Softwareentwicklung zugeschrieben, obwohl er nur Beratung und Einführung anbietet. Der wichtigste Befund ist deshalb die falsche Einordnung.
Das Team prüft Leistungsseite und relevante Unternehmensprofile, präzisiert seine Aufgaben und dokumentiert die Änderungen. Im folgenden Messzyklus untersucht es zusätzlich, ob die fehlerhafte Darstellung seltener wird. Claude, Gemini und Google erhalten eigene Auswertungen.
Beispiel: Onlineshop für Fahrradzubehör
Ein Shop beobachtet Fragen zu wasserdichten Packtaschen. KI-Antworten verlinken seinen Ratgeber, nennen bei Kaufempfehlungen aber andere Händler.
Das Team entdeckt eine konkrete Informationslücke: Auf den Produktseiten fehlen verständliche Angaben zu Befestigungssystemen und passenden Fahrradtypen. Es ergänzt geprüfte Informationen und verbessert den Übergang vom Ratgeber zur Produktauswahl.
Anschließend beobachtet es Quellenlinks, passende Empfehlungen und erkennbare Shopbesuche. Ein Bestellanstieg allein wäre noch kein Nachweis für GEO-Erfolg; gleichzeitig laufende Werbung und Aktionen werden bei der Bewertung berücksichtigt.
Wie startest du in den nächsten 30 Tagen?
Nutze den ersten Monat, um ein funktionierendes Messverfahren aufzubauen. Der Zeitraum ist keine Zusage, dass sich bereits eine Optimierungswirkung nachweisen lässt.
- Woche 1: Ein Thema auswählen, zehn Kundenfragen festlegen, Wettbewerber bestimmen und Bewertungskriterien vereinbaren. Die Ausgangslage an mehreren Terminen erfassen.
- Woche 2: Antworten prüfen, technische Ausfälle dokumentieren und wiederkehrende Informationslücken priorisieren. GA4-Quellen und den Google-Bericht kontrollieren.
- Woche 3: Wenige begründete Änderungen umsetzen. Betroffene URLs, Datum und erwartete Wirkung festhalten.
- Woche 4: Mit unverändertem Vergleichsset erneut beobachten und einen kurzen Bericht erstellen. Frühe Hinweise von belastbaren Entwicklungen unterscheiden.
Für den manuellen Einstieg kannst du einen wöchentlichen Beobachtungstermin und eine monatliche Gesamtauswertung vereinbaren. Das ist eine organisatorische Empfehlung. Umfang und Frequenz hängen von deinen Ressourcen und der Bedeutung des Themas ab.
Benenne eine Person für die Messung und eine für die fachliche Prüfung. Für ein Team ist entscheidend, dass es aus dem Reporting priorisierte Aufgaben ableiten kann.
FAQ zur Messung von KI-Sichtbarkeit
Kann ich KI-Sichtbarkeit kostenlos messen?
Du kannst mit manuellen Tests und einer eigenen Tabelle ohne zusätzliches Monitoring-Abonnement starten. Berücksichtige deinen Zeitaufwand und mögliche Nutzungsgrenzen der KI-Dienste. Websiteanalysen und Googles Sichtbarkeitsbericht ergänzen die Beobachtung.
Wie messe ich meine Sichtbarkeit in ChatGPT?
Teste relevante Kundenfragen wiederholt unter dokumentierten Bedingungen. Erfasse Markennennungen, Empfehlungen und eigene Quellenlinks. Halte Modell, Suchmodus und Zeitpunkt fest und werte die Ergebnisse getrennt von anderen Systemen aus.
Welche Erwähnungsquote ist gut?
Es gibt keinen allgemein gültigen Zielwert. Die Quote hängt von deinen Fragen, Systemen und Zählregeln ab. Vergleiche deine Entwicklung und passende Wettbewerber innerhalb desselben Messaufbaus.
Reicht die Google Search Console für GEO-Monitoring?
Die Search Console reicht nicht für plattformübergreifendes GEO-Monitoring. Ihr Bericht zu generativen KI-Funktionen zeigt Impressionen in Googles Suchfunktionen. Nennungen in ChatGPT, Claude und Gemini musst du gesondert untersuchen.
Bedeutet ein Quellenlink, dass die KI meine Marke empfiehlt?
Ein Quellenlink bedeutet zunächst, dass eine Seite sichtbar verlinkt wird. Er ist keine automatische Produktempfehlung. Prüfe, welche Aussage damit verbunden ist und ob deine Marke überhaupt genannt wird.
Wie schnell kann ich GEO-Erfolg nachweisen?
Es gibt keine allgemeine Frist für einen belastbaren GEO-Erfolgsnachweis. Ein erster Messzyklus liefert eine Ausgangslage. Für die Bewertung von Änderungen brauchst du weitere vergleichbare Beobachtungen und Geschäftsdaten.
Fazit: KI-Sichtbarkeit mit klaren Fragen bewerten
Wenn du KI-Sichtbarkeit messen möchtest, beginne mit relevanten Kundenfragen, eindeutigen Zählregeln und getrennten Auswertungen pro System. Ergänze beobachtete Antworten um Googles Sichtbarkeitsdaten, erkennbare Besuche und qualifizierte Geschäftsergebnisse.
Ein hilfreiches Reporting endet mit einer Entscheidung: Welche Information fehlt, welche Darstellung muss korrigiert werden und welchen nächsten Schritt setzt dein Team um?
Wenn du dieses Vorgehen gemeinsam mit deinem Team auf eure Website oder euren Shop übertragen möchtest, bietet unser SEO-Seminar für Unternehmen einen individuell anpassbaren Rahmen. Wenn du ein GEO-Messkonzept im Team entwickeln möchtest, kannst du dafür ein individuelles Inhouse-Seminar anfragen.


Lerne die digitalen Skills von morgen
Melde dich zum Newsletter an und erhalte regelmäßig konkrete Tipps, Strategien und Inspiration rund um Online-Marketing, E-Commerce, KI und digitales Business.