A/B-Tests im Onlineshop: Hypothesen, Laufzeit und Auswertung
Geschätzte Lesezeit: 11 Min.

Deine neue Produktseite wirkt übersichtlicher. Aber kaufen dadurch tatsächlich mehr Menschen? Ein A/B-Test im Onlineshop hilft dir, eine konkrete Änderung unter vergleichbaren Bedingungen zu bewerten. Dafür brauchst du eine begründete Hypothese, eine passende Stichprobe und vorab festgelegte Regeln für die Auswertung.
Dieser Leitfaden zeigt dir den Weg von der ersten Beobachtung bis zur Entscheidung. Du erfährst auch, wann dein Traffic für einen Test nicht ausreicht. Alle Zahlen und Shopbeispiele sind hypothetisch.
Das Wichtigste in Kürze
Bei einem A/B-Test sehen zufällig zugeordnete Gruppen gleichzeitig eine Ausgangsvariante und eine veränderte Variante. Du vergleichst eine vorher festgelegte Zielkennzahl. Die benötigte Laufzeit hängt von Ausgangsrate, gesuchtem Effekt, statistischem Verfahren und geeignetem Traffic ab. Ein signifikanter Unterschied allein rechtfertigt noch keinen Rollout: Datenqualität, Unsicherheit und wirtschaftliche Auswirkungen gehören ebenfalls zur Entscheidung.
Was ist ein A/B-Test im Onlineshop?
Ein A/B-Test ist ein kontrolliertes Experiment. Variante A ist beispielsweise deine bisherige Produktseite, Variante B dieselbe Seite mit einer überarbeiteten Größenberatung. Geeignete Besucher werden zufällig zugeteilt und bleiben während des Tests ihrer Variante zugeordnet.
Die zeitgleiche Ausspielung hilft, gemeinsame Einflüsse wie Wochentage oder Kampagnen zu berücksichtigen. Randomisierung erzeugt dabei nicht zwangsläufig exakt gleiche Gruppen. Sie macht eine systematische Bevorzugung bei korrekter Umsetzung unwahrscheinlicher und ermöglicht die statistische Bewertung.
Ein Vorher-nachher-Vergleich bietet diese Kontrolle nicht. Steigt die Kaufquote nach einem Relaunch, können auch andere Produkte, neue Anzeigen oder eine Rabattaktion mitgewirkt haben.
A/B-Testing ist ein Baustein der systematischen Conversion-Optimierung. Die Analyse zeigt, wo du genauer hinschauen solltest. Der Test untersucht die Wirkung einer ausgewählten Änderung.
Wie entwickelst du eine überprüfbare Testhypothese?
Eine gute Hypothese verbindet eine Beobachtung mit einer vermuteten Ursache, einer konkreten Änderung und einer erwarteten Wirkung. „Wir testen ein anderes Layout“ beschreibt dafür zu wenig.
Beginne mit einer belegbaren Nutzerhürde
Untersuche zunächst, welche Informationen oder Funktionen Menschen auf dem Weg zum Kauf benötigen. Hinweise findest du beispielsweise in Supportfragen, Suchanfragen innerhalb des Shops, Funnel-Daten oder beobachteten Bedienproblemen.
Ein hoher Ausstieg auf einer Produktseite erklärt die Ursache noch nicht. Vielleicht fehlen Größeninformationen. Vielleicht vergleichen Menschen lediglich Preise. Deine Erklärung bleibt eine Vermutung, bis du sie genauer untersucht hast.
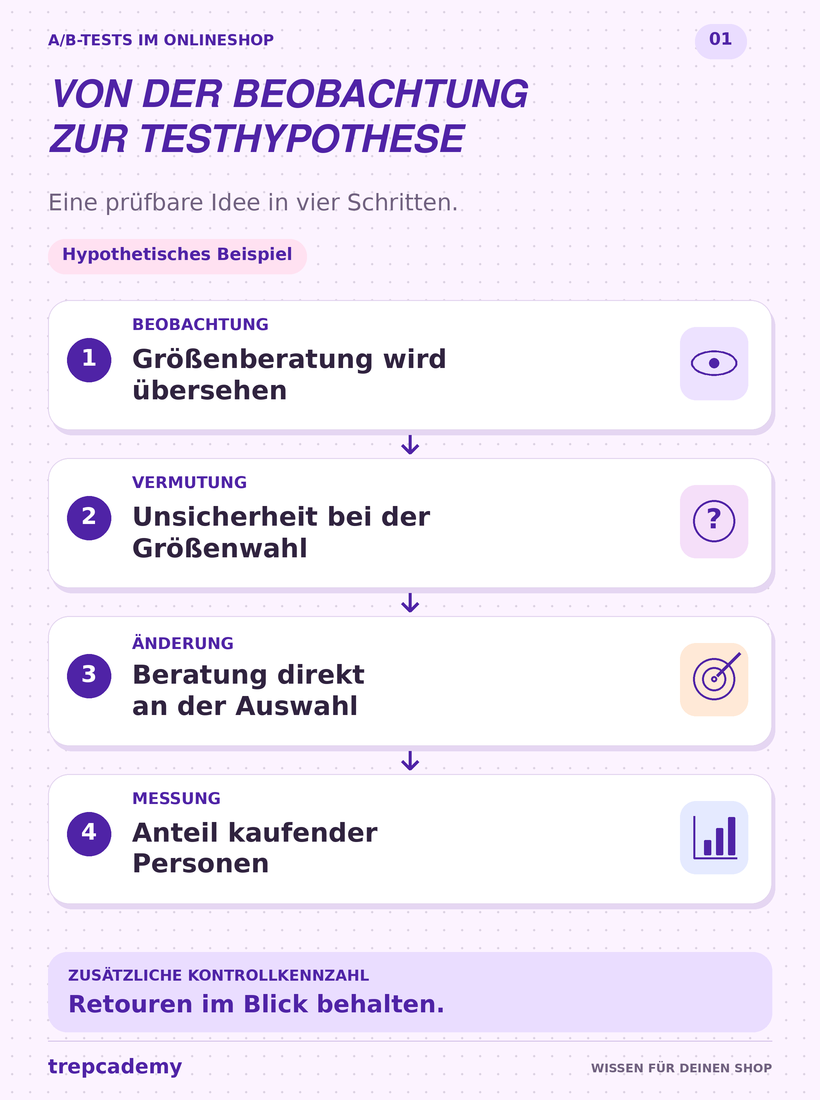
Für ein hypothetisches Bekleidungsgeschäft könnte der Befund lauten: Im Kundenservice häufen sich Fragen zur Passform, und in Nutzertests wird die vorhandene Größentabelle übersehen.
Verbinde Änderung, Wirkmechanismus und Messgröße
Eine passende Hypothese wäre:
Wenn wir die Größenberatung direkt neben der Größenauswahl verständlich zugänglich machen, steigt der Anteil kaufender Personen unter den teilnehmenden Produktseitenbesuchern, weil die Unsicherheit bei der Größenwahl sinkt.
Damit sind Änderung, Zielgruppe, vermuteter Wirkmechanismus und Erfolgskriterium benannt. Ob Größenretouren später zunehmen oder abnehmen, prüfst du zusätzlich, sofern diese Daten zuverlässig zugeordnet werden können.
Verändere für den ersten Test eine klar beschriebene Lösung. Sie darf aus mehreren zusammengehörigen Anpassungen bestehen. Dann bewertest du allerdings das gesamte Maßnahmenpaket. Welcher einzelne Bestandteil wirkt, lässt sich daraus nicht isoliert ableiten.
Welche Änderungen solltest du zuerst testen?
Priorisiere Ideen anhand der Belege für das Problem, des möglichen Geschäftswerts, des verfügbaren Testvolumens und des Umsetzungsrisikos. Eine gut begründete Änderung an einer häufig genutzten Produktvorlage ist oft praktikabler als eine Detailidee auf einer selten besuchten Unterseite.
Typische Ansatzpunkte sind:
- Produktseite: Größenberatung, Kompatibilitätsinformationen oder eine verständlichere Variantenauswahl.
- Warenkorb: klarer ausgewiesene Gesamtkosten oder besser erkennbare nächste Schritte.
- Checkout: verständlichere Fehlermeldungen oder eine leichter auffindbare Gastbestellung.
- Kategorie: Filterbeschriftungen oder Informationen auf Produktkarten.
Keine dieser Ideen ist automatisch ein Gewinner. Ein tatsächlich defekter Kaufbutton braucht außerdem eine Fehlerbehebung statt eines Wettbewerbs gegen die funktionierende Version.
Welche Kennzahlen gehören in den Testplan?
Lege eine primäre Kennzahl fest, bevor der Test startet. Für eine Änderung mit Kaufziel kann das der Anteil der zugeteilten Personen sein, die innerhalb eines definierten Zeitfensters mindestens einmal bestellen.
Kaufquote = Personen mit mindestens einem Kauf ÷ teilnehmende Personen × 100.
Zähle jede Person für diese Kennzahl höchstens einmal als kaufend. Die Gesamtzahl der Bestellungen und die Anzahl der Sitzungen sind andere Größen. Sie dürfen nicht ungeprüft in eine Auswertung für unabhängige Personen übernommen werden.
Ergänze die Hauptkennzahl durch Kontrollkennzahlen, auch Guardrails genannt. Dazu können technische Fehler, Umsatz oder Deckungsbeitrag je teilnehmender Person gehören. Retouren und Stornos sind hilfreich, benötigen aber häufig längere Beobachtungszeiten.
Mehr Warenkorbklicks beantworten eine engere Frage als mehr Käufe. Wenn du einen solchen Zwischenschritt zum Hauptziel machst, dokumentiere diese Begrenzung. Eine höhere Klickrate belegt keinen Umsatzgewinn.
Wenn du mehrere Varianten, Ziele oder nachträglich ausgewählte Segmente auf Signifikanz prüfst, steigt ohne Anpassung das Risiko zufälliger Treffer. Plane solche Vergleiche mit einem Verfahren, das Mehrfachtests berücksichtigt. Eine Hauptkennzahl vorab festzulegen schützt nicht automatisch alle zusätzlichen Vergleiche.
Wichtig ist auch die Bezugsgruppe: Analysiere die vorab definierte Testpopulation. Wenn eine Variante beeinflusst, wer überhaupt den Checkout erreicht, kann ein nachträglicher Vergleich nur der Checkout-Besucher irreführend sein.
Wie viele Besucher brauchst du für einen A/B-Test?
Es gibt keine universelle Mindestzahl. Für einen klassischen Vergleich zweier Kaufquoten brauchst du insbesondere vier Planungsgrößen: die bisherige Rate, den kleinsten zu untersuchenden Effekt, das Signifikanzniveau und die gewünschte Teststärke.
Ausgangsrate und minimaler Effekt
Die Ausgangsrate sollte aus einem vergleichbaren Zeitraum und derselben Zielgruppe stammen. Eine shopweite Kaufquote passt nicht automatisch zu einem Test, der ausschließlich bestimmte Produktseiten betrifft.
Der Minimum Detectable Effect, kurz MDE, ist die Effektgröße, auf die du deinen Test mit festgelegter Teststärke auslegst. Bestimme zusätzlich, ab welcher Verbesserung sich eine Umsetzung wirtschaftlich lohnt. Beide Werte sollten sinnvoll zusammenpassen.
Von 3 auf 3,6 Prozent bedeutet eine Zunahme um 0,6 Prozentpunkte beziehungsweise 20 Prozent relativ. Eine Verbesserung um 20 Prozentpunkte wäre etwas völlig anderes.
Signifikanzniveau und Teststärke
Ein Signifikanzniveau von 5 Prozent begrenzt bei gültigen Modellannahmen die langfristige Rate falsch positiver Entscheidungen unter der Nullhypothese. Es bedeutet nicht, dass ein einzelnes positives Ergebnis mit 95 Prozent Wahrscheinlichkeit richtig ist.
Die Teststärke, auch Power genannt, beschreibt die Wahrscheinlichkeit, einen tatsächlich vorhandenen Effekt einer bestimmten Größe zu erkennen. Bei 80 Prozent Power bleibt für diese Effektgröße ein Risiko von ungefähr 20 Prozent, ihn nicht nachzuweisen.
Für die Planung zweier unabhängiger Anteile werden diese Größen gemeinsam berücksichtigt. Kleinere nachzuweisende Unterschiede benötigen unter sonst gleichen Bedingungen mehr Daten.
Ein hypothetisches Planungsbeispiel
Angenommen, du planst einen zweiseitigen Test mit gleich großen Gruppen:
- Ausgangsrate: 3 Prozent.
- Zu erkennende Rate: 3,6 Prozent.
- Signifikanzniveau: 5 Prozent.
- Teststärke: 80 Prozent.
Eine übliche Normalapproximation ohne Kontinuitätskorrektur ergibt rund 13.914 Personen je Variante. Für die Planung runden wir auf 14.000 je Variante und 28.000 insgesamt. Andere Verfahren können etwas abweichende Werte liefern.
Das ist eine Berechnung unter Annahmen, keine Zusage, dass dein Test später einen Gewinner zeigt. Die neue Variante kann wirkungslos sein, schlechter abschneiden oder einen kleineren Effekt haben.
Wie lange sollte ein A/B-Test laufen?
Die Rekrutierungsdauer ergibt sich näherungsweise aus der insgesamt benötigten Stichprobe geteilt durch die täglich neu hinzukommenden geeigneten Testpersonen. Zusätzlich berücksichtigst du Geschäftszyklen und das Zeitfenster, in dem Käufe gezählt werden.
Im Beispiel mit 28.000 Personen ergeben sich bei insgesamt 1.000 neuen geeigneten Personen pro Tag etwa 28 Tage Rekrutierung. Bei 100 pro Tag wären es etwa 280 Tage. Wiederkehrende Besuche derselben bereits zugeordneten Personen vergrößern die nutzerbasierte Stichprobe nicht erneut.
Shop-Traffic ist deshalb nicht automatisch Test-Traffic. Wenn nur ein Teil der Besucher die relevante Seite erreicht oder nur ein Teil des geeigneten Traffics teilnimmt, verlängert sich die Rekrutierung entsprechend.
Plane typische Wochen- und Kaufzyklen ein. Zwei volle Wochen können ein organisatorischer Ausgangspunkt sein, ersetzen aber weder Stichprobenplanung noch Beobachtung des Kaufverhaltens. Ein über Monate laufender Test kann wiederum schwer zu steuern sein, wenn Sortiment oder technische Rahmenbedingungen wechseln.
Definiere auch die Nachbeobachtung. Neu zugeteilte Personen am letzten Testtag brauchen dieselbe vorab festgelegte Gelegenheit zum Kauf wie früher zugeteilte Personen. Das vollständige Ergebnis kann deshalb erst nach Ende der Rekrutierung vorliegen.
Darfst du bei einem frühen Gewinner abbrechen?
Bei einer klassischen Auswertung mit fest geplantem Ende solltest du nicht täglich auf Signifikanz prüfen und beim ersten günstigen Wert stoppen. Diese Abbruchregel erhöht das Risiko falscher positiver Befunde.
Es gibt eigens dafür entwickelte sequenzielle Verfahren. Die Unterscheidung zwischen festen und sequenziellen Testverfahren erklärt, warum die Entscheidungsregeln zum verwendeten Modell passen müssen. Ein gewöhnlicher Online-Rechner macht einen laufenden Test nicht nachträglich zu einem sequenziellen Experiment.
Technische Defekte oder vorab definierte Sicherheitsprobleme können einen Abbruch erfordern. Dokumentiere dann den Grund und werte den abgebrochenen Versuch nicht einfach wie einen regulär beendeten Test aus.

Was muss vor dem Start technisch funktionieren?
Die Varianten müssen zuverlässig ausgespielt und konsistent gemessen werden. Ob du dafür ein Shopsystem-Plugin, eine clientseitige Lösung oder eine serverseitige Umsetzung verwendest, hängt von deiner Architektur und der Änderung ab.
Prüfe vor dem Start insbesondere:
- Zuteilung: Erfolgt sie zufällig und bleibt die Zuordnung bei wiederholten Besuchen stabil?
- Darstellung: Funktionieren beide Varianten mobil und am Desktop, einschließlich Warenkorb und Zahlvorgang?
- Messung: Werden Käufe, Testkennzeichnung und Zeitfenster in beiden Gruppen nach denselben Regeln erfasst?
- Performance: Entstehen Flackern, zusätzliche Wartezeiten oder Fehler?
- Abgrenzung: Können parallele Tests oder Releases denselben Bereich beeinflussen?
Halte fest, wie Gerätewechsel, gelöschte Kennungen und fehlende Messdaten behandelt werden. Ein System erkennt reale Personen nicht automatisch über alle Geräte hinweg.
Prüfe außerdem das Verhältnis der zugeteilten Gruppen. Eine kleine Abweichung von 50 zu 50 ist normal. Eine statistisch auffällige Abweichung wird als Sample Ratio Mismatch bezeichnet und kann auf Zuteilungs- oder Erfassungsprobleme hinweisen. Microsoft Research beschreibt diese Prüfung der Stichprobenverteilung als wichtigen Schritt vor der Ergebnisbewertung.
Bei Tests mit separaten URLs berücksichtigt die Umsetzung zusätzlich die Google-Empfehlungen für Website-Tests: kein Cloaking, geeignete Canonical-Verweise und bei vorübergehenden Weiterleitungen grundsätzlich 302 statt 301. Räume die Testkonfiguration nach Abschluss auf.
Wie wertest du einen A/B-Test richtig aus?
Beginne mit der Datenqualität. Erst wenn Population, Gruppenzuordnung, Messung und Testverlauf plausibel sind, vergleichst du die Geschäftsergebnisse.
Berechne Rate und Effektgröße
Angenommen, der geplante Test ist abgeschlossen und liefert folgende hypothetische Daten:
- Variante A: 14.000 Personen, davon 420 mit mindestens einem Kauf.
- Variante B: 14.000 Personen, davon 504 mit mindestens einem Kauf.
- Kaufquote A: 3 Prozent.
- Kaufquote B: 3,6 Prozent.
- Absolute Differenz: plus 0,6 Prozentpunkte.
- Relative Veränderung: plus 20 Prozent.
Für den Vergleich solcher tatsächlich erhobenen Daten kannst du den A/B-Test-Rechner von trepcademy verwenden. Er zeigt Conversion-Raten, Unterschiede und bei ausreichenden Zahlen einen zweiseitigen p-Wert. Stichprobe und Laufzeit plant er nicht; Trackingfehler oder eine fehlerhafte Randomisierung erkennt er ebenfalls nicht automatisch.
Interpretiere den p-Wert korrekt
Ein zweiseitiger Zwei-Anteile-z-Test mit gepoolter Varianz ergibt für dieses Beispiel ungefähr p = 0,005.
Unter der Annahme gleicher zugrunde liegender Kaufquoten beschreibt der p-Wert, wie wahrscheinlich eine mindestens ebenso extreme Teststatistik wäre. Er ist weder die Wahrscheinlichkeit, dass B gewinnt, noch die Wahrscheinlichkeit, dass die Nullhypothese stimmt.
Der Unterschied ist unter den Modellvoraussetzungen auf dem vorab festgelegten 5-Prozent-Niveau statistisch signifikant. Daraus folgt keine Garantie für künftige Ergebnisse. Die Grundsätze der American Statistical Association zu p-Werten betonen zudem, dass Signifikanz weder die Effektgröße noch die praktische Bedeutung misst.
Ein nicht signifikanter Befund beweist umgekehrt keine Gleichwertigkeit. Dafür brauchst du eine entsprechend geplante Fragestellung und Auswertung.
Betrachte auch die Unsicherheit
Ein Konfidenzintervall ergänzt den Punktschätzer um seine statistische Unsicherheit. Für das Beispiel liegt ein näherungsweises 95-Prozent-Wald-Intervall der absoluten Differenz bei plus 0,18 bis plus 1,02 Prozentpunkten.
Die Berechnung folgt einer Normalapproximation für die Differenz zweier Anteile. Andere Intervallverfahren können abweichende Grenzen ergeben. Der trepcademy-Rechner zeigt dieses Intervall nicht an.
Ein 95-Prozent-Konfidenzverfahren würde bei vielen vergleichbaren Wiederholungen etwa 95 Prozent der so gebildeten Intervalle über den tatsächlichen Parameter legen. Für die Entscheidung heißt das: Der beobachtete Anstieg um 0,6 Prozentpunkte ist keine exakt feststehende Wirkung.
Trenne statistischen Befund und Geschäftsentscheidung
Prüfe anschließend, ob die mögliche Verbesserung den Aufwand rechtfertigt und die Kontrollkennzahlen mittragen. Mehr Käufe können mit kleineren Warenkörben oder höheren variablen Kosten einhergehen.
Wenn sich eine Umsetzung erst ab plus 0,5 Prozentpunkten lohnt, ist das Beispiel trotz statistischer Signifikanz wirtschaftlich noch nicht eindeutig: Das Intervall umfasst auch kleinere Verbesserungen.
Für Umsatz oder Deckungsbeitrag je Person brauchst du eine dazu passende statistische Auswertung. Diese kontinuierlichen Kennzahlen lassen sich nicht einfach mit einem Rechner für binäre Kaufquoten testen.

Was tun, wenn dein Shop zu wenig Traffic hat?
Prüfe vor dem Start, ob die notwendige Stichprobe innerhalb eines sinnvollen Zeitraums erreichbar ist. Wenn dafür viele Monate nötig wären, überdenke die Untersuchung.
Du kannst gegebenenfalls eine stärker wirksame, gut begründete Änderung untersuchen oder dieselbe Variante auf einer passenden Produktvorlage ausspielen. Dabei muss die gemeinsame Zielgruppe fachlich sinnvoll bleiben. Ein nachträglich höher angesetzter MDE erzeugt keine zusätzliche Evidenz.
Häufig helfen zunächst qualitative Untersuchungen. Lass Menschen aus deiner Zielgruppe eine konkrete Kaufaufgabe bearbeiten, untersuche wiederkehrende Supportfragen und behebe nachvollziehbare Bedienprobleme. Die Unterscheidung zwischen qualitativen und quantitativen Usability-Tests hilft, die richtige Methode zu wählen.
Qualitative Erkenntnisse zeigen mögliche Probleme und Lösungsansätze. Sie beziffern keinen kausal nachgewiesenen Umsatzanstieg. Auch eine Vorher-nachher-Auswertung nach einer Verbesserung bleibt durch andere Einflüsse begrenzt.
Wie hältst du Testergebnisse für dein Team fest?
Ein kurzer Teststeckbrief verhindert, dass später nur die Gewinnerzahl in Erinnerung bleibt. Dokumentiere:
- Beobachtung, Hypothese, Zielgruppe und Varianten.
- Hauptkennzahl, Kontrollkennzahlen und wirtschaftliche Entscheidungsschwelle.
- Statistisches Verfahren, Planungsannahmen, Stichprobe und Regeln für das Testende.
- Rekrutierungszeitraum, Nachbeobachtung und technische Auffälligkeiten.
- Effekt, Unsicherheit, Entscheidung und nächste Untersuchung.
Auch ein unklares Ergebnis gehört hinein. Unterscheide zwischen „ausreichend untersuchter kleiner Wirkung“, „zu unpräzisem Befund“ und „wegen Messproblemen nicht belastbar“.
Lege außerdem fest, wer einen Rollout freigibt, ihn technisch umsetzt und die Funktion danach kontrolliert. Ein Testergebnis wird erst nutzbar, wenn daraus eine nachvollziehbare Entscheidung entsteht.
FAQ zu A/B-Tests im Onlineshop
Wie viele Besucher braucht ein A/B-Test?
Die benötigte Zahl hängt insbesondere von Ausgangsrate, gesuchtem Effekt, Signifikanzniveau und Teststärke ab. Im hypothetischen Beispiel mit 3 Prozent Ausgangsrate und einem gesuchten Anstieg auf 3,6 Prozent sind es näherungsweise 14.000 Personen je Variante.
Reichen zwei Wochen Testlaufzeit?
Zwei Wochen reichen nur, wenn Stichprobe, relevante Geschäftszyklen und Beobachtungsfenster dazu passen. Eine feste Zahl an Tagen macht einen Test nicht automatisch aussagekräftig.
Was bedeutet ein signifikanter A/B-Test?
Ein signifikanter Befund erfüllt die vorab festgelegte statistische Entscheidungsregel unter den Modellannahmen. Er garantiert weder einen bestimmten Mehrumsatz noch die dauerhafte Überlegenheit einer Variante.
Darf ich Sitzungen in den A/B-Test-Rechner eintragen?
Für den trepcademy-Rechner brauchst du unabhängige, zufällig zugeordnete Personen und Personen mit Conversion. Sitzungen oder Bestellereignisse sind kein automatischer Ersatz. Prüfe, ob die Zähleinheit deiner Daten zur Auswertungsmethode passt.
Kann ich mehrere Änderungen gleichzeitig testen?
Du kannst eine Ausgangsversion gegen ein zusammenhängendes Maßnahmenpaket testen. Das Ergebnis betrifft dann das Paket. Ein multivariater Test untersucht gezielt Kombinationen mehrerer Faktoren und braucht eine entsprechend umfangreichere Planung.
Was mache ich ohne eindeutigen Gewinner?
Prüfe Datenqualität, Effektintervall und ursprüngliche Planung. Ein unklarer Befund rechtfertigt keine Behauptung, die Varianten seien gleich. Dokumentiere die Unsicherheit und entscheide anhand des vorab festgelegten Plans über das weitere Vorgehen.
Kann ich den Test einfach verlängern?
Eine spontane Verlängerung, weil Signifikanz knapp verfehlt wurde, verändert die Entscheidungsregel. Halte dich an die vorher festgelegte Planung oder verwende ein Verfahren, das solche Anpassungen ausdrücklich berücksichtigt.
Fazit: Gute Shoptests beginnen vor dem Start
Ein belastbarer A/B-Test im Onlineshop beginnt mit einer konkreten Nutzerhürde. Daraus entstehen Hypothese, Messplan, Stichprobe und passende Laufzeit. Nach Abschluss bewertest du Datenqualität, Effektgröße, Unsicherheit und wirtschaftliche Bedeutung gemeinsam.
Nimm dir für den nächsten Test zunächst eine relevante Frage vor und schreibe die Entscheidungsregeln auf. Wenn die Datenmenge nicht reicht, nutze passende qualitative Methoden.
Wenn du diese Arbeitsweise mit deinem Team auf eigene Seiten übertragen möchtest, kannst du bei trepcademy ein individuelles Inhouse-Seminar anfragen. Inhalte und Übungen werden auf eure Vorkenntnisse, Ziele und konkreten Projekte abgestimmt.


Lerne die digitalen Skills von morgen
Melde dich zum Newsletter an und erhalte regelmäßig konkrete Tipps, Strategien und Inspiration rund um Online-Marketing, E-Commerce, KI und digitales Business.